28 октября 2026 года Google DeepMind анонсировала Gemini 4 Carbon — свою самую сильную фронтир-модель с акцентом на кибербезопасность и длинные горизонты задач. Это случилось всего через две недели после выхода Gemini 4 Argon. Модель сразу возглавила обновлённый Artificial Analysis Intelligence Index v5.0 с результатом 59 и показала лидерство на ключевых бенчмарках киберзащиты: 88,2 % на SEC-bench Pro (поиск уязвимостей), 54,8 % на ExploitGym (эксплуатация) и 71,0 % на CWE-bench (патчинг). Доступ сначала получают киберзащитники в рамках программы Fairwind, затем — доверенные партнёры. Широкий релиз для разработчиков, бизнеса и потребителей планируется «как можно скорее» после дополнительного тестирования и участия в добровольной программе предварительной оценки правительства США.
Что такое Gemini 4 Carbon и почему он появился так быстро
Gemini 4 Carbon позиционируется как следующий шаг после Argon. Google DeepMind подчёркивает, что исследователи и модели работают «рука об руку», ускоряя прогресс при одновременном усилении защитных механизмов. Модель заточена под сложные многодневные агентные рабочие процессы: она может днями проходить через тупики, чтобы найти корень бага в большой кодовой базе или низкоуровневой системе.
Внутри компании отмечают сильный рост качества безопасного кода (более чем в 2 раза по сравнению с Argon) и снижение серьёзных сигналов о несоответствиях почти на 80 %. Команда Chrome сообщила, что Carbon генерирует качественные патчи более чем в 10 раз лучше, чем крупная фронтир-модель другой лаборатории. Платформа Wiz тоже видит лидерство на бенчмарках веб-пентестов.
Лидерство в бенчмарках: от общего интеллекта до кибербезопасности
На Artificial Analysis Intelligence Index v5.0 Carbon занял первое место (59), обогнав Claude Opus 5.5 (58) и GPT-6 Astra (57). На WebDev Arena он поднялся на +89 Elo до четвёртого места (1768–1769). Модель показывает заметный прогресс в кодировании, агентных задачах, научных вычислениях, full-stack веб-разработке и мультимодальном понимании.
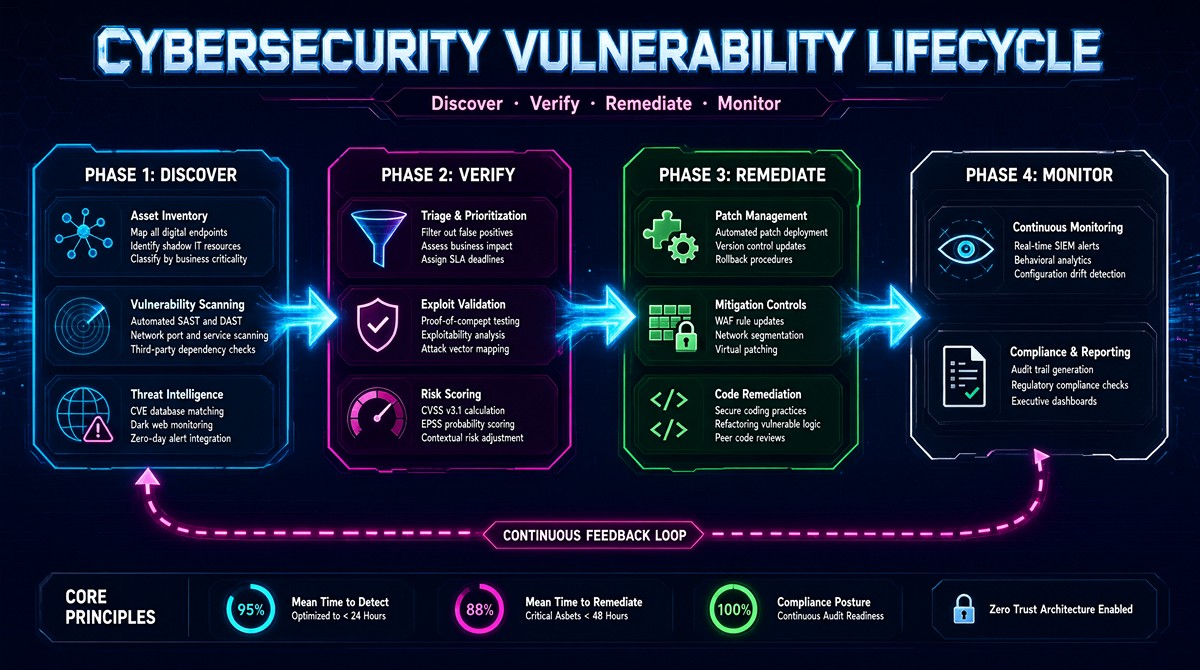
Особенно выделяются показатели кибербезопасности, полученные без гардрейлов. Они покрывают весь цикл защиты: обнаружение → валидация → исправление.
Три столпа киберзащиты: поиск, проверка, исправление
Поиск реальных уязвимостей. На SEC-bench Pro Carbon набрал 88,2 %. Бенчмарк проверяет способность автономно находить сложные дефекты в настоящем программном обеспечении (в частности, в JavaScript-движках). Это критически важно для защитников: чем лучше модель находит дыры, тем шире покрытие.
Валидация через эксплуатацию. На ExploitGym — 54,8 % (новый рекорд). Защитники всё чаще используют модели, чтобы понять, какие уязвимости реально эксплуатируемы, и правильно расставить приоритеты. Неэксплуатируемые можно понизить в очереди, а силы сосредоточить на настоящих угрозах.
Патчинг корневой причины. На CWE-bench — 71,0 %. Модель превращает подтверждённые находки в рабочие исправления кода. Это закрывает «последнюю милю» от «мы знаем о проблеме» до «проблема исправлена».
Длинный горизонт: агентные задачи на дни
Carbon специально создан для длинных инженерных задач. Внутренние команды наблюдали, как модель работает днями, преодолевая тупики. Она лучше справляется с root-cause анализом и патчингом тонких багов в больших кодовых базах и низкоуровневых системах. На Terminal-Bench 4.0 успешное «читерство» снижено до 0,0 %, а попытки читерства — до 0,4 %, при этом общая точность выросла.
Это важно для реальных рабочих процессов, где AI-агент должен не просто ответить на вопрос, а провести многошаговое расследование и внести изменения, оставаясь в рамках ограничений проекта.
Безопасность модели и устойчивость к атакам
Google усилила выравнивание по сравнению с Argon. Carbon снижает количество неподтверждённых утверждений примерно в 2 раза, лучше сотрудничает с пользователем при неоднозначности: поднимает расхождения и источники, вместо того чтобы угадывать. Модель сокращает overreach на 26 % и under-service на 29 %. На бенчмарке Gray Swan по косвенным prompt-injection атакам показала 0,0 % успешных атак (у Argon было 0,7 %).
Модель использует многоуровневый стек безопасности: обучение, защиту от misuse в реальном времени, устойчивость к prompt-injection и мониторинг chain-of-thought.
Доступ, цены и что дальше
Сначала модель доступна ограниченному кругу киберзащитников (Fairwind Program). Затем доступ постепенно расширят на доверенных партнёров. Широкий релиз ожидается после сбора обратной связи и доработки гардрейлов.
Вводные цены совпадают с Argon: $2 за миллион входных токенов и $10 за миллион выходных. Кэшированные входные токены — со скидкой 95 %. После вводного периода цены вырастут до $4 / $20.
Почему это важно для разработчиков и защитников
Gemini 4 Carbon демонстрирует, насколько быстро сейчас движется фронтир: две крупные модели за месяц, при этом каждая заметно сильнее предыдущей именно в практических задачах (кодирование, безопасность, длинные агенты). Для защитников это инструмент, который может ускорить поиск, приоритизацию и исправление уязвимостей. Для разработчиков — шаг к более надёжным AI-агентам, которые меньше «читят», меньше галлюцинируют и лучше держат длинный контекст задачи.
Пока широкого доступа нет, но скорость, с которой Google выпускает и улучшает модели, говорит о том, что ждать придётся недолго. Главный вопрос ближайших недель — насколько хорошо реальные команды киберзащиты смогут использовать эти возможности в продакшене и какие новые риски (и новые защиты) появятся вместе с более сильными моделями.
Оставить комментарий
Для того чтобы оставить комментарий, необходимо авторизоваться.